AI 生成的幻灯片为什么需要这一步
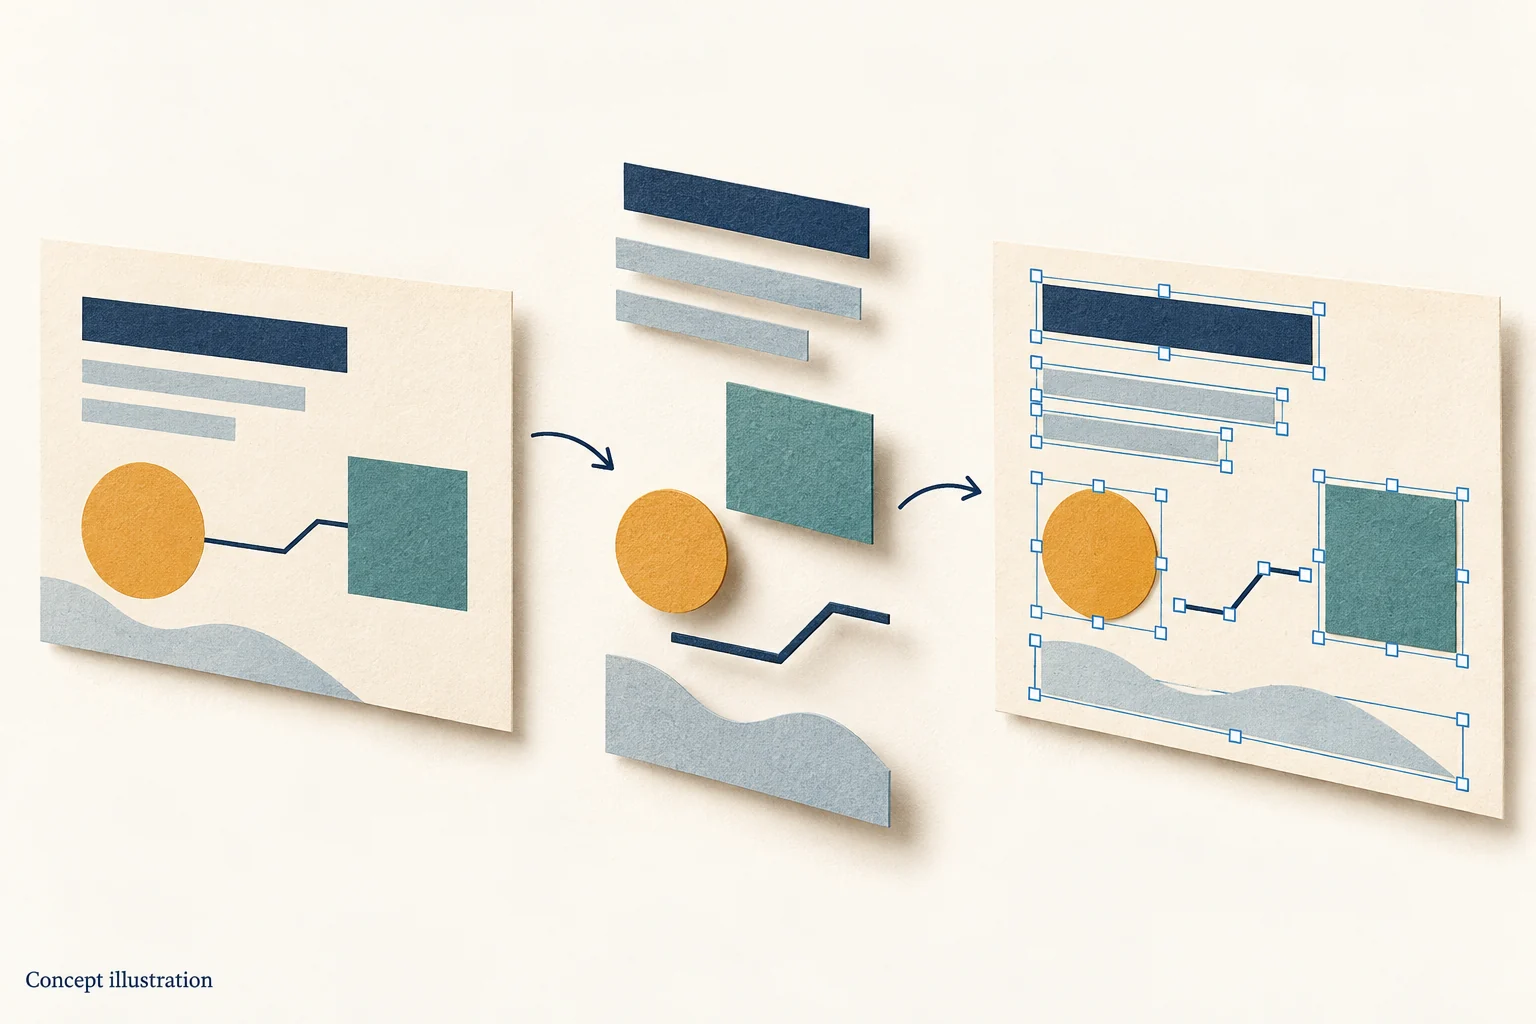
生成模型输出的是像素,不是文件。它看起来像一份合格的幻灯片,但没有文本框、没有形状、没有表格,也没有图层。想要换成公司字体、改一个数字、加一条备注,都只能重做。ChatGPT 图片转 PPT 这一步做的,就是把这些像素重新量成文字框、形状和表格:同一张图,转完之后换公司字体、改一个数字、加一条备注都是几分钟的事,不用回到对话框重新生成。
AI 图片里的文字要特别核对
AI 生成的文字经常有拼写错误或无法辨认的字符,转换会如实还原你图上的内容——包括错字。所以转完先在编辑器里通读一遍再导出,比在 PowerPoint 里发现更省事。
AI 图转 PowerPoint 后能做什么
把装饰性的色块改成品牌色、把文案换成真实数据、删掉不需要的元素、把卡片重新排序。文字是文本,形状是形状,不用整页重画。
常见的 AI 版式还原效果
大标题加卡片、时间轴、流程图、左右对比这类版式效果最好,因为元素边界清楚。插画式、纹理很重的页面会有损失,文字位置可能需要在编辑器里微调。
AI 生成图和真实截图的差别
真实截图有稳定的栅格对齐:卡片边缘落在整数像素上,文字基线彼此平行。生成图会带轻微透视、随机阴影和不一致的圆角半径,识别时这些偏差会被当成真实的形状差异。所以转换之后,位置检查要比处理截图时更仔细。
先让模型把字写对,再谈转换
生成模型写字的能力不稳定,四个字的名字可能写成三个。这一点在转换端无法修正,只能在上游想办法:提示词里把关键文案直接给出、每页字数压到三十个以内、避免小字号正文。字越少,出错的位置就越少。
ChatGPT 图片转 PPT 的三步
先把生成的图存成原始尺寸的 PNG,不要用对话框里的缩略图;再上传,等文字、形状和图标各自成对象;最后在编辑器里改完导出 .pptx。三步里最容易被跳过的是第一步,而它恰恰决定了小字能不能留下来。
什么时候该重新生成,而不是转换
如果整页版式本身就不对——信息层级乱、留白失衡、配色冲突——转换只会把问题固化下来,回到对话框改提示词重生成更快。反过来,版式已经满意、只差几个字或几个数字时,才是拆解真正省时间的时候。
别用截图代替原始生成图
截图会二次采样,等于把生成图再压一遍,小字和细线先糊。对话框里通常有下载原图的入口,用原始文件上传,转换能多留住一些笔画细节——这一点对 AI 图比普通截图更关键,因为生成图的字本来就偏软。
常见问题
Midjourney 生成的图也能转吗?
能,流程一样。只要画面里有清晰可辨的文字和形状,就能拆成对象。
AI 图里的假文字会被纠正吗?
不会。转换忠实于图片内容,错字会照原样保留,需要你在编辑器里改。
生成图里的字体能保留吗?
字体会按视觉特征匹配到可用字体,不会保留生成模型虚构的字体;导出后用 PowerPoint 换字体很方便。
生成图分辨率更高会更准吗?
会。生成分辨率越高,小字样例越清楚,拆解结果越稳。如果工具支持指定尺寸,优先要 16:9 的大图。
ChatGPT 图片转 PPT 会保留原来的配色吗?
会按像素取色,主色基本能对上,但渐变和半透明叠加会有偏差。品牌色要求严格时,导出后统一换一次填充更可靠。